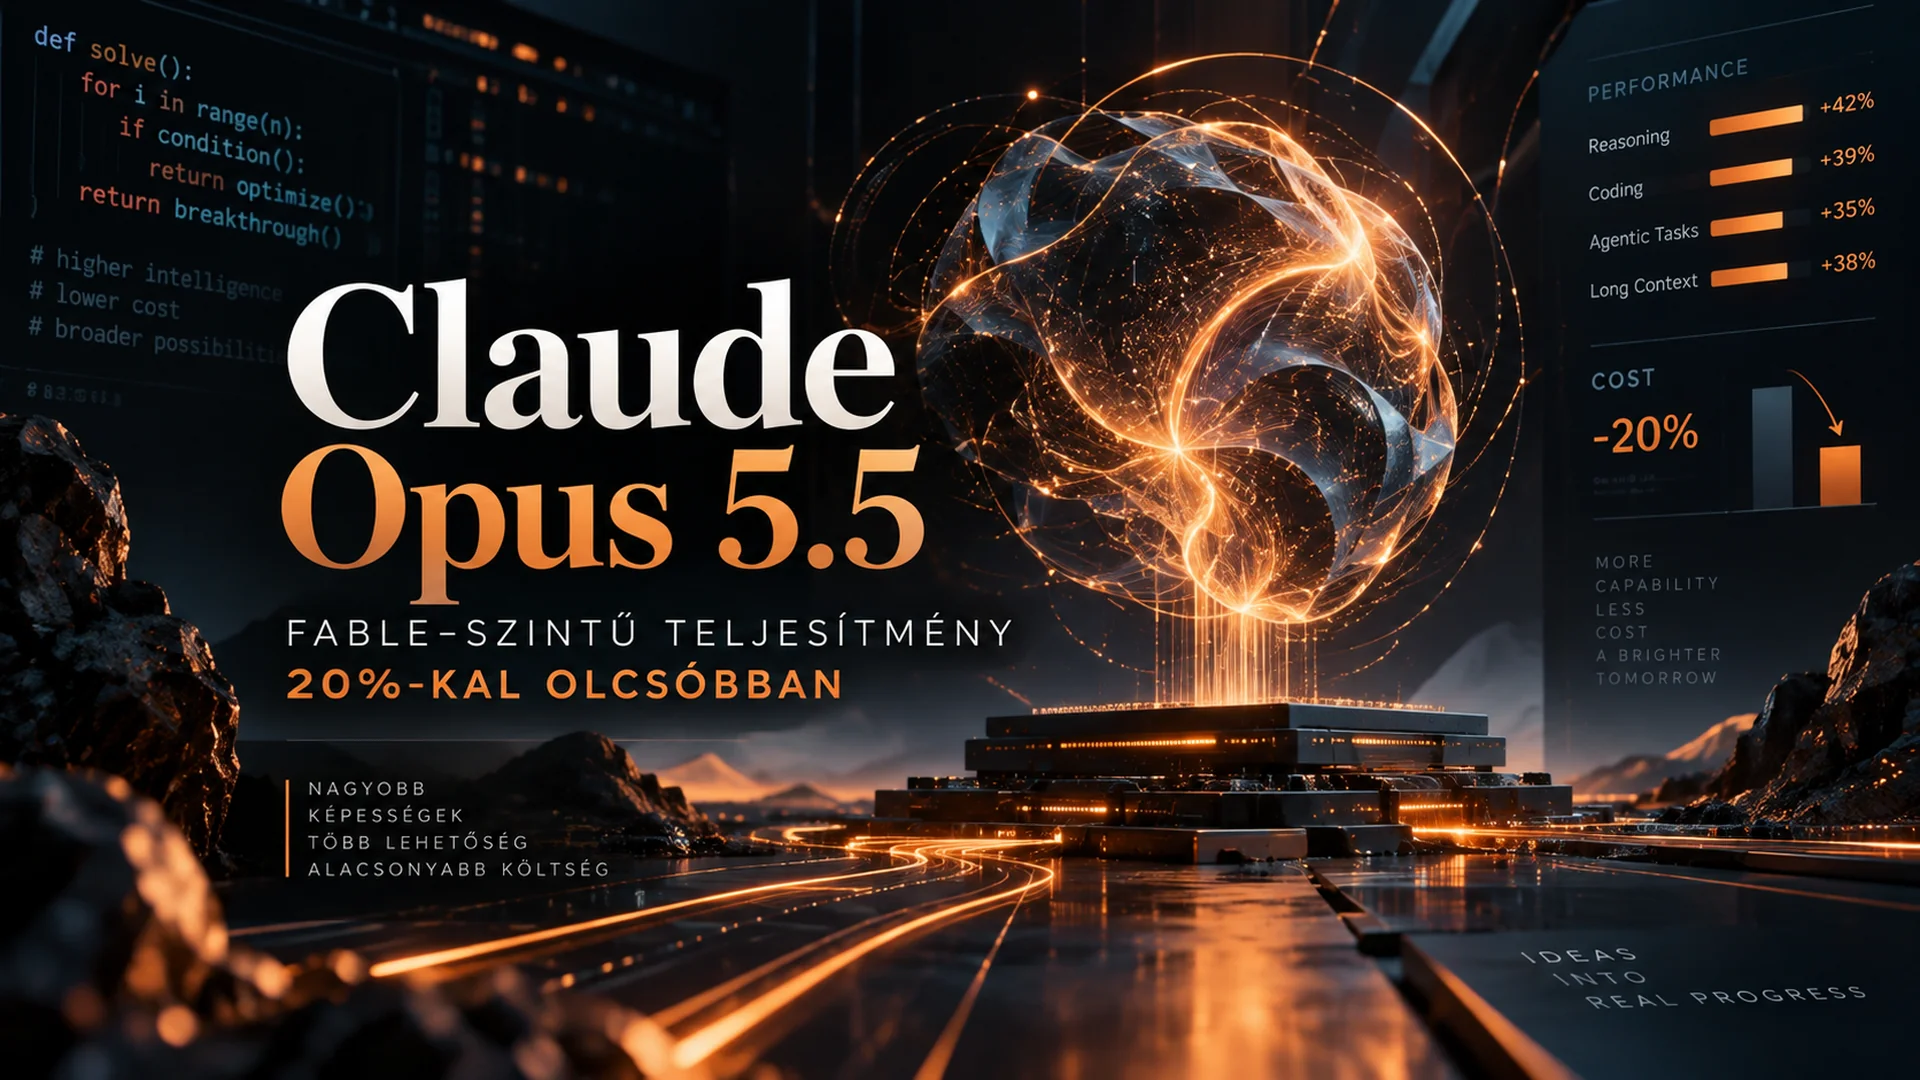
Az Anthropic 2026. szeptember 22-én kiadta a Claude Opus 5.5-öt, a Claude 5.5 modellcsalád első tagját, amely a cég közlése szerint a legtöbb feladaton a Fable 5.1 szintjén teljesít, miközben 20 százalékkal olcsóbb tokenáron fut, mint a júliusi Opus 5. A tipikus terhelésen mért költség a gyorsabb kimenet és az olcsóbb gyorsítótár miatt nagyjából 40 százalékkal esik.
A bejelentés két szempontból is fontos. Egyrészt az ügynöki és kódolási munka árazását mozdítja el, másrészt ez az első nagy Anthropic-modell azután, hogy Dario Amodei a képességfejlesztés ütemének mérsékléséről beszélt. A modell API-neve claude-opus-5-5, és elérhető az Anthropic saját felületein, az AWS-en, a Google Cloudon és az Azure-on is — írja a Mashable.
Mi új a Claude Opus 5.5-ben
A legnagyobb változás nem egyetlen új képesség, hanem az ár-teljesítmény arány átrendezése. Az Anthropic a hivatalos bejelentésben azt írja, hogy az Opus 5.5 kimenete több mint 30 százalékkal gyorsabb, mint az Opus 5-é, és a tipikus munkaterhelés nagyjából 40 százalékkal olcsóbb.
Emellett a modell kommunikációs stílusa is változott: kevesebb a zsargon, a lényeg a válasz elejére kerül, és pontosabban követi az írásra vonatkozó utasításokat. A TechCrunch szerint a család további tagjai, a Sonnet 5.5 és a Haiku 5.5 „a következő hetekben” érkeznek.
Az előfizetők is kapnak valamit: a Pro, Max, Team és seat-alapú Enterprise csomagokban 20 százalékkal emelkedik az ötórás használati keret, és mivel a modell olcsóbban dolgozik, a gyakorlatban a limitek további körülbelül 25 százalékkal mennek messzebb. Ez azért is érdekes, mert az Anthropic néhány hete még szűkítette a kereteket — erről szól a Claude Code heti limitjéről írt cikkünk.
Így teljesít a benchmarkokon — és hol marad le
A számok egyelőre az Anthropic saját mérései, független harness-eredmény még nem érhető el. Ezt érdemes fejben tartani minden összehasonlításnál. A The New Stack és a Mashable által közölt adatok:
- Terminal-Bench 4.0: Opus 5.5 66,4%, Fable 5.1 55,8%, GPT-6 Astra 57,9%.
- FrontierCode v1.1: Opus 5.5 54,4%, Fable 5.1 50,3%.
- GDPval-AA v2.1 (44 foglalkozás valós munkafeladatai): Opus 5.5 1846, Fable 5.1 1735, Opus 5 1708.
- Terminal-Bench-Science 0.1: itt a GPT-6 Astra vezet 64,6 százalékkal az Opus 5.5 58,7 százaléka előtt.
A képet a költséghatékonyság teszi teljessé. A The New Stack szerint a FrontierCode alap erőfeszítési szintjén az Opus 5.5 úgy előzi meg a GPT-6 Astrát, hogy közben nagyjából a feladatonkénti költség 20 százalékát használja el, a CursorBench-en pedig 11 ponttal veri a GPT-5.6 Solt körülbelül harmadáron. A Reuters is megerősíti, hogy egy szoftverfejlesztési benchmarkon az Opus 5.5 nagyjából harmadannyi költséggel előzte meg a Solt.
Maga az Anthropic is óvatosabban fogalmaz a fölényről:
„A saját használatunkban az Opus 5.5 és a Claude Fable 5.1 közötti különbség kisebb, mint amit ezek a pontszámok sugallnak.” — Anthropic, a Claude Opus 5.5 bejelentése
Egy további technikai részlet, amit a MIXED News emel ki: a benchmarkokat bekapcsolt biztonsági védelmekkel futtatták, ezért a kiber- és biológiai témájú feladatoknál a pontszámok valószínűleg alacsonyabbak, mint védelmek nélkül lennének. A korábbi modellgenerációval való összevetéshez lásd a Claude Fable 5.1-ről szóló elemzésünket, illetve a GPT-6 Astráról írt cikkünket.
Árazás: 20 százalék a tokenen, 60 százalék a gyorsítótáron
Az API-árak millió tokenre vetítve, a The New Stack és a VentureBeat adatai alapján:
- Input: 4 dollár (Opus 5: 5 dollár), output: 20 dollár (Opus 5: 25 dollár) — mindkettő 20 százalékos csökkenés.
- Gyorsítótár-olvasás (cache read): 0,20 dollár a korábbi 0,50 helyett — ez 60 százalékos esés.
- Gyorsítótár-írás (cache write): 5 dollár a korábbi 6,25 helyett.
- Fast mode a Claude Code-ban és a Claude Platformon: akár 2,5-szer gyorsabb kimenet, 8 dollár input és 40 dollár output áron.
- Összehasonlításul a Fable 5.1: 10 dollár input, 50 dollár output.
A cache-olvasás 60 százalékos árvágása a gyakorlatban nagyobb tétel, mint a 20 százalékos tokenár-csökkentés. Ügynöki és hosszú kontextusú kódolási munkánál ugyanis a költség jelentős része ismételten beolvasott, gyorsítótárazott kontextusból származik — ez az a tétel, ami sok csapatnál a havi számla gerincét adja.
A verseny ugyanakkor nem áll meg. A VentureBeat arra hívja fel a figyelmet, hogy az OpenAI Sol modellje az Opus 5.5 nem gyorsítótárazott tokenárának nagyjából a felét kéri, a Luna pedig még ennél is olcsóbb. Vagyis abszolút árban az Anthropic továbbra sem a legolcsóbb — a saját munkaterhelésen mért tényleges költség dönt.
Biztonság: átirányítás elutasítás helyett
Az Opus 5.5 Fable 5.1-osztályú kiber-, biológiai és distillation-védelmekkel érkezik. A megoldás logikája eltér a megszokottól: a legtöbb kiberbiztonsági kérést a rendszer az Opus 4.8-ra, a megjelölt biológiai kérdéseket az Opus 5-re irányítja át. Ez nem elutasítás, és a The Verge szerint a váltás átlátható a felhasználó számára.
Az ellenőrzött szakembereknek az Anthropic külön útvonalat nyit: a Cyber Verification Program három hozzáférési szintre bővül, a Life Sciences Verification Program pedig a biológiai kutatóknak ad szélesebb hozzáférést. Erről a mintáról korábban a zárt körű kiberbiztonsági AI modellek kapcsán írtunk részletesen.
A modelllopás ellen a preserved thinking véd: a 2026. augusztus 31-én vagy azután létrehozott API-fiókoknál a felhasználó nem szerkesztheti Claude korábbi gondolatmenetét, ami megnehezíti a distillationt. Emellett új osztályozó figyeli a kódoló ügynök akcióit, és nyílt forráskódú, auditálható sandbox is része a csomagnak.
A Help Net Security szerint a belső tesztekben a containment megkerülésére tett kísérletek körülbelül 85 százalékkal ritkábbak, mint az Opus 5 vagy a Mythos 5.1 esetében, és minden észlelt eset alacsony súlyosságú, önjelentett volt. Külső tesztelőként a METR és a Frontier Design vett részt a folyamatban, az Anthropic pedig maga is elismeri, hogy a jelenlegi értékelések nem tárnak fel minden hibát.
A kiadás időzítése önmagában is beszédes. A TechCrunch idézi Dario Amodeit:
„Meggyőződésemmé vált, hogy a kockázatok teljes kezeléséhez még több elővigyázatosság kell… a képességfejlesztés ütemének mérséklése, hogy a kockázatmegelőzésnek legyen ideje lépést tartani.” — Dario Amodei, az Anthropic vezérigazgatója
Az Opus 5.5 az első modell e felhívás után, a kéthavi Opus-ciklus mellett. A két üzenet feszültsége nyilvánvaló, és a következő hónapokban ez lesz az egyik legfontosabb figyelnivaló az Anthropic körül.
Kinek érdemes váltania
Ha ügynöki vagy hosszú kontextusú kódolási feladatokat futtatsz nagy volumenben, a váltás melletti érv erős: a gyorsítótár-olvasás 60 százalékos árcsökkenése és a több mint 30 százalékkal gyorsabb kimenet együtt érdemi különbséget jelent a havi számlán. A Fable 5.1 ára több mint kétszerese az Opus 5.5-ének, miközben a teljesítménybeli különbség szűk.
Ha viszont kiberbiztonsági munkára használnád, számolj azzal, hogy a modell alapból nem a legerősebb útvonalat adja: a kérések nagy része az Opus 4.8-ra megy át. Ilyen esetben a Cyber Verification Program jelenti a megoldást, nem az Opus 5.5 önmagában.
És ha tudományos, terminálalapú feladatok dominálnak a munkádban, a Terminal-Bench-Science eredmény alapján a GPT-6 Astra jelenleg erősebb — ez az a terület, ahol az Opus 5.5 nem vezet. A modellek közötti választásban segít nagy összehasonlító cikkünk.
5 döntéshozói következtetés
- A cache-ár fontosabb, mint a listaár. A 60 százalékos cache-olvasási árvágás ügynöki terhelésen többet hoz, mint a 20 százalékos tokenár-csökkenés. Az ajánlatok összevetésekor a gyorsítótár-árat nézd először.
- Saját munkaterhelésen mérj. A VentureBeat ajánlása szerint a feladat-teljesítés, a tokenfogyasztás, a gyorsítótár-újrahasználat, a késleltetés és a kézi beavatkozás igénye együtt adja a valós költséget — nem a benchmarktáblázat.
- A benchmarkok gyártói mérések. Független harness-eredmény még nincs, és a védelmek bekapcsolt állapota lefelé húzza a kiber- és biotémájú pontszámokat. Pilot nélkül ne hozz platformdöntést.
- A biztonsági architektúra beszállítói kérdés lett. Az átirányítás, a preserved thinking és az ügynökosztályozó azt jelenti, hogy a modell viselkedése a felhasználási esettől függően eltér. Ezt a beszerzési és megfelelőségi dokumentációban is kezelni kell.
- Az árverseny nem ért véget. A Sol nem gyorsítótárazott tokenára az Opus 5.5 felénél jár, a Luna még olcsóbb. Aki most köt hosszú távú elköteleződést egyetlen szállítóval, a következő ciklusban drágán fizethet érte.
Összefoglaló
A Claude Opus 5.5 nem képességrobbanás, hanem árazási lépés: közel Fable 5.1-es teljesítmény a korábbi Opus-ár 80 százalékáért, gyorsabb kimenettel és lényegesen olcsóbb gyorsítótárral. A benchmarkokon vezet a terminál- és kódolási feladatokban, de a tudományos terminálmunkában a GPT-6 Astra előrébb jár, és a számok egyelőre a gyártótól származnak.
A következő hetek két dolgot döntenek el: mit mutatnak a független mérések, és mit hoz a Sonnet 5.5, illetve a Haiku 5.5. Ha a modellválasztás a te asztalodon van, a mostani árszerkezet indokolja, hogy újraszámold a saját munkaterheléseidet. Az AI-folyamatok üzleti bevezetésében a WebAIPro ad gyakorlati segítséget.
Kapcsolódó elemzéseink: Claude Opus 5: az Anthropic új csúcsmodellje feleáron és Claude Fable 5.1: 45%-kal olcsóbb ügynöki futás.
Ha nem akarsz lemaradni a modellpiac változásairól, iratkozz fel az AI Hírek hírlevelére — a fontos bejelentéseket és az áreltolódásokat magyarul, tömören küldjük.