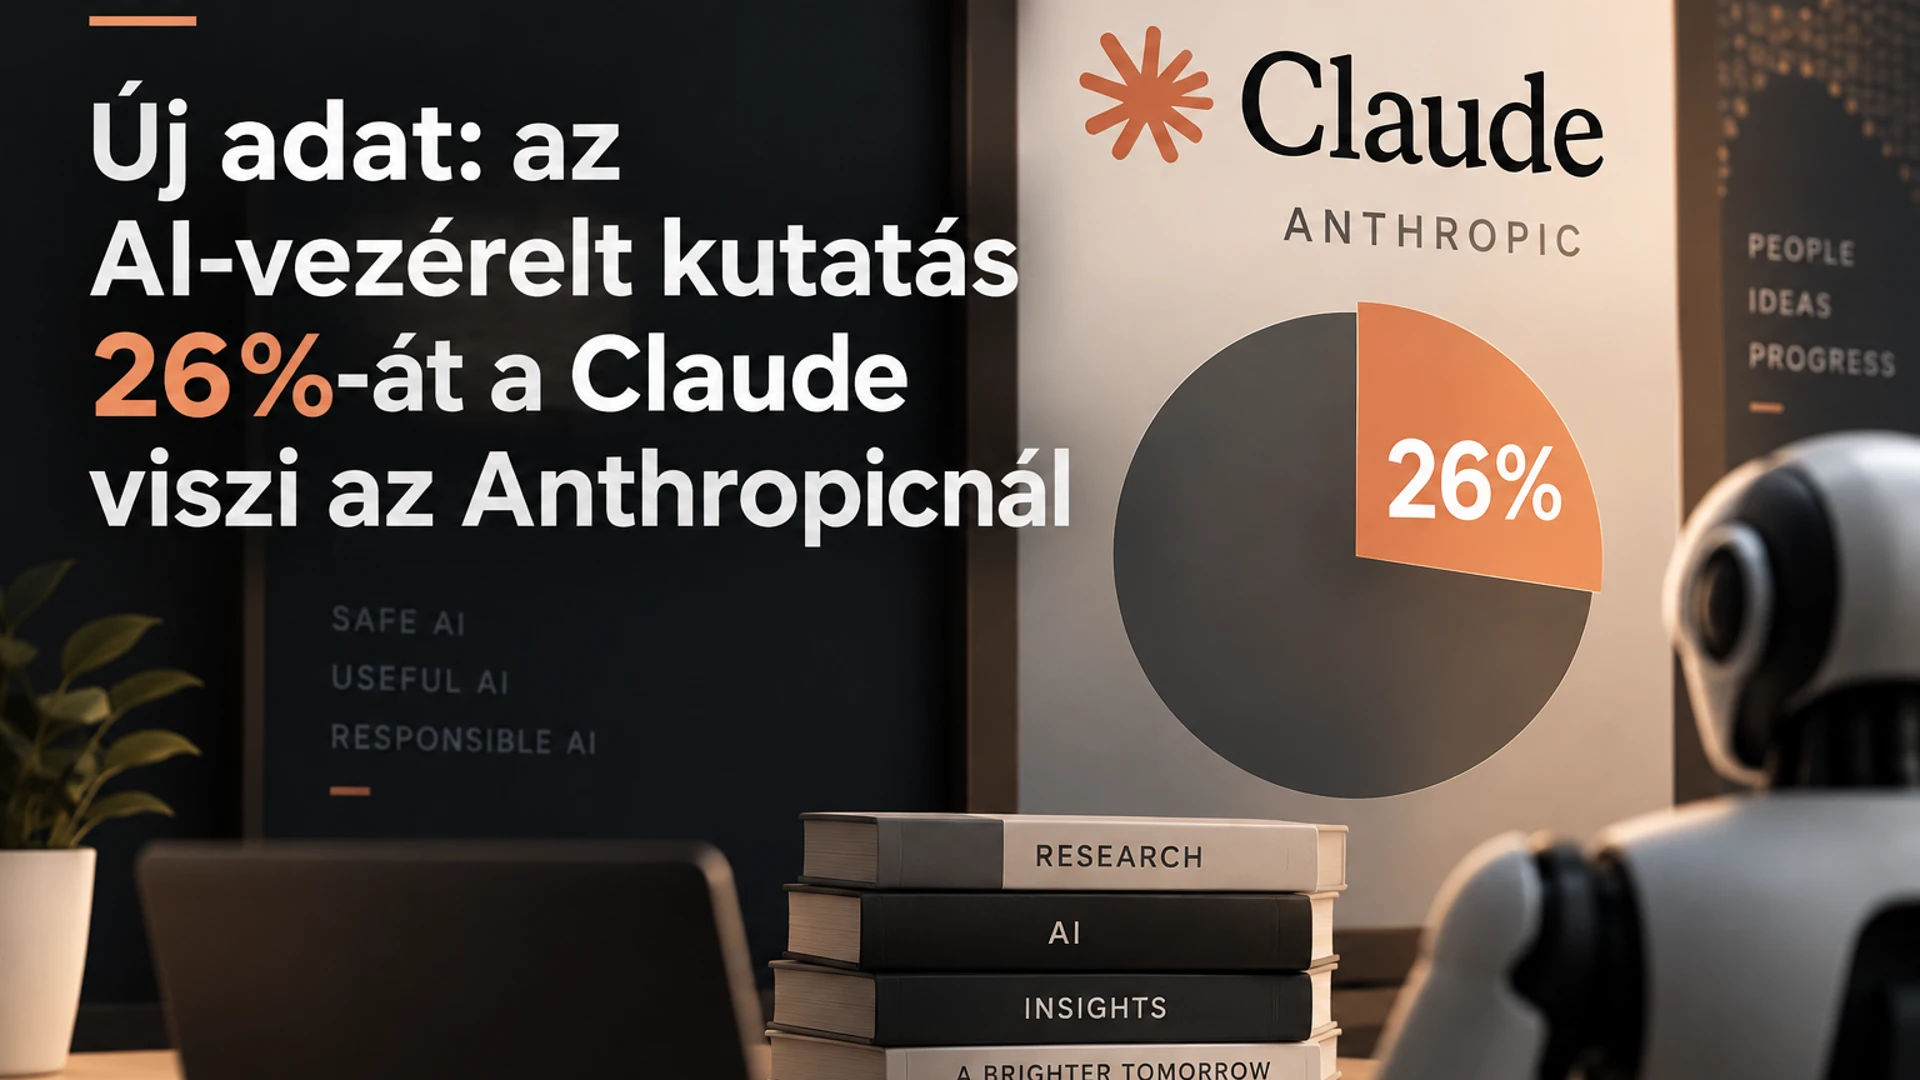
Az AI-vezérelt kutatás már az Anthropic belső K+F feladatainak 26 százalékát teszi ki: ennyit visz végig önállóan a Claude — derül ki a cég új, átláthatósági mérési keretrendszeréből. Ez nem marketingszám: az Anthropic első alkalommal tette közzé szintekre bontva, hogy a saját mérnökei és kutatói mekkora arányban adják át a munka irányítását a modellnek.
A szám azért fontos neked is, ha nem AI-laborban dolgozol. Ha a világ egyik vezető modellfejlesztőjénél a feladatok negyedét már nem ember viszi végig, akkor az ágens-alapú munkaszervezés nem jövőkép, hanem működő gyakorlat. A kérdés az, hogy mit lehet ebből átemelni egy hétköznapi céges munkafolyamatba.
Mit mutat az AI-vezérelt kutatás 26 százalékos aránya?
Az Anthropic 2026 szeptemberében publikálta azt a mérési rendszert, amellyel a belső K+F munkafolyamataiban követi az AI szerepét. A legfontosabb adatok:
- 26% AI-vezérelt feladat: 2026 augusztusára a mért K+F feladatok 26 százalékát a Claude önállóan, egy magas szintű instrukcióból kiindulva teljesítette.
- 1% alól 26%-ra fél év alatt: 2026 februárjában ez az arány még egy százalék alatt volt.
- 90% feletti AI-jelenlét: a mérnöki és kutatási munkafolyamatok több mint 90 százalékában jelen van a Claude legalább szoros együttműködési szinten.
- 30 000 párhuzamos ágens: az elsődleges belső fejlesztői platformon egy adott pillanatban átlagosan ennyi autonóm ágens fut egyszerre.
- 1 milliárd vizsgált ágens-művelet: augusztus folyamán ennyi belső ágens-döntést elemeztek valós időben.
Az Engadget beszámolója szerint a publikáció célja éppen a mérhetőség: az iparágban eddig anekdotákban beszéltek arról, mennyit dolgozik az AI a modelleken, konkrét arányszámok nélkül.
Hogyan mérik az autonómiát? Az AL0–AL5 skála
A keretrendszer az Epoch AI hatszintes automatizálási skáláját használja. Ez azért hasznos, mert ugyanezzel a logikával a saját céges folyamataidat is be tudod sorolni:
- AL0 — nincs AI: a feladat teljes egészében emberi munka.
- AL1 — egyszerű asszisztencia: kódkiegészítés, mondatbefejezés szintjén.
- AL2 — instruált támogatás: az ember lépésről lépésre diktálja, mit csináljon a modell.
- AL3 — szoros együttműködés: tandem munka, ahol az AI már önálló részfeladatokat old meg.
- AL4 — AI-vezérelt: a modell egy magas szintű célból önállóan végigviszi a feladatot, az ember a folyamatot és a végeredményt felügyeli.
- AL5 — teljes autonómia: emberi beavatkozás nélküli zárt lánc.
„A ‘vezetés’ azt jelenti, hogy a modell képes egy magas szintű instrukció alapján a feladat túlnyomó részét önállóan, elejétől a végéig elvégezni, miközben az emberi kutató felügyeli a folyamatot és a kimenetet, ahelyett hogy minden egyes lépést kézzel diktálna.”
A 26 százalék tehát az AL4 szintre vonatkozik. Az AL5-öt — a teljesen emberi felügyelet nélküli működést — az Anthropic közlése szerint egyetlen mért K+F részterületen sem engedélyezték. Ez a különbségtétel a hír legfontosabb része: a leglátványosabb szám mögött szigorú felügyeleti korlát áll.
A biztonsági réteg: mit tanulhatsz belőle?
Ahol harmincezer ágens fut párhuzamosan, ott a felügyelet nem emberi szemmel történik. Az Anthropic online monitorozó rendszere a vizsgált műveletek 0,002 százalékát minősítette kockázatosnak és állította le automatikusan — nagyjából minden 47 000. lépést.
Egy júliusi mintahét adatai szerint a teljes K+F számítási kapacitás 6 százaléka ment dedikáltan biztonsági kutatásra, és az AI-vezérelt feladatok körén belül ez az arány elérte a 12 százalékot. Vagyis minél önállóbban dolgozik a modell, annál nagyobb hányadot kell a saját ellenőrzésére fordítani.
Ez az arány céges léptékben is átgondolandó. Ha ágenseket engedsz éles folyamatra — számlázásra, ügyfél-kommunikációra, kódra —, a felügyeleti és naplózási munkát ugyanúgy be kell tervezni, mint magát az automatizálást. A tapasztalat szerint ez az a pont, ahol a legtöbb bevezetés elcsúszik: az ágens működik, de senki nem nézi, mit csinált.
Kapcsolódó elemzésünk: AI-ügynök a gyakorlatban: hol lesz az új szűk keresztmetszet?
Mit jelent ez a mérnöki munkára?
A mérés legfontosabb következménye a szerepváltás. A kutató és a fejlesztő ideje a közvetlen gépelésről a kísérletvezetésre és az ágensek ellenőrzésére tolódik át. Az Anthropic tapasztalata szerint egy ember párhuzamosan 30–50 ágens kísérleteit tudja felügyelni.
Ez gyakorlatilag azt jelenti, hogy a munkakör közelebb kerül a projektvezetéshez, mint a klasszikus kivitelezéshez. A napi feladat már nem az, hogy megírd a kódot, hanem hogy pontosan megfogalmazd a célt, jól válaszd meg a kísérleteket, és megbízhatóan eldöntsd, melyik kimenet jó és melyik nem.
A készséglista is ehhez igazodik: a specifikációírás, a kiértékelési szempontok felállítása és a hibás kimenetek gyors felismerése fontosabb lesz, mint a szintaktikai rutin. Erről szól a gyakorlati oldala annak, amit korábban a Claude kódírási arányáról írtunk.
Kapcsolódó elemzésünk: Rekurzív önjavítás: a Claude írja az Anthropic kódjának 80%-át
A rekurzív önfejlesztés kapujában
A számok mögött egy hosszabb távú folyamat rajzolódik ki. Amikor a csúcsmodellek már a következő generáció architektúra-kísérleteit és tanítóadatait készítik elő, a fejlesztési ciklusidő hónapokról hetekre rövidülhet. Ezt az iparági kommentárok a rekurzív önfejlesztés első mérhető jelének tekintik.
Ugyanez a folyamat magyarázza, miért nő közben a biztonsági kutatásra fordított kapacitás is. Minél gyorsabban fejleszti a rendszer önmagát, annál kevesebb idő marad az emberi utólagos ellenőrzésre — ezért kell a felügyeletet eleve a folyamatba építeni.
Kapcsolódó elemzésünk: Anthropic lassítási terv: Amodei fékezné az AI-t
Iparági következmény: jön a mérési sztenderd
Az Anthropic publikációja azért is jelentős, mert precedenst teremt. Ha egy labor számokkal közli, hol tart az AI-vezérelt kutatás aránya, a többi szereplőnek — az OpenAI-nak, a Google DeepMindnak, a Metának — nehezebb lesz általánosságokkal válaszolni. Az automatizálási szintek egységes skálája az első lépés afelé, hogy az „AI segíti a kutatásunkat” típusú mondatok helyett összehasonlítható adatok kerüljenek nyilvánosságra.
Hasonló mérési logikával találkoztunk már az OpenAI oldalán is, ahol az ügynök-munkaidőt emberi munkanapokra vetítve közölték.
Kapcsolódó elemzésünk: OpenAI automatizált kutató gyakornok: 3,1 ügynök-munkanap jut 1 emberire
Mit kezdj ezzel a saját cégedben?
Az AI-vezérelt kutatás keretrendszerének legjobban hasznosítható része nem a 26 százalék, hanem maga a mérési szemlélet. Négy lépés, amit érdemes lemásolni:
- Sorold be a folyamataidat: nézd végig a visszatérő feladataidat, és tedd őket AL0–AL4 szintre. A legtöbb cégnél kiderül, hogy AL1–AL2 szinten állnak, miközben AL3 már elérhető lenne.
- Mérj arányt, ne érzést: havonta rögzítsd, hány feladatot vitt végig az AI önállóan. E nélkül nincs mihez képest fejlődni.
- Tervezd be a felügyeletet: ha az ágens önállóan dolgozik, a naplózás és a kimenet-ellenőrzés külön erőforrás, nem melléktermék.
- Tartsd meg az emberi döntési pontot: az AL5 még a fejlesztőnél sincs engedélyezve — éles üzleti folyamatban végképp korai.
Ha ennek a felmérésnek és az automatizálás bevezetésének a gyakorlati részéhez kell segítség, azzal a WebAIPro foglalkozik.
Amit a 26 százalék nem jelent
A szám könnyen félreérthető, ezért érdemes pontosan elhatárolni. A 26 százalék feladatarány, nem munkaidő-arány: azt mutatja, hogy a mért K+F feladatok hányadában a modell vitte a végrehajtást, nem azt, hogy az emberi munka negyede feleslegessé vált. A felügyelet, a célkitűzés és a kiértékelés végig emberi munka maradt.
Azt sem jelenti, hogy ezek a feladatok ellenőrzés nélkül futottak volna le. Az AL4 definíció szerint az ember a folyamatot és a kimenetet is felügyeli — a különbség az, hogy nem lépésenként avatkozik be. A teljesen felügyelet nélküli AL5 szint külön kategória, és az Anthropic közlése szerint sehol nem engedélyezett.
Végül nem általánosítható tetszőleges munkakörre sem. A mérés egy AI-labor kutatás-fejlesztési feladataira vonatkozik, ahol a feladatok jól definiáltak, gépi úton kiértékelhetők, és a visszacsatolás gyors. Ahol a siker kritériuma nehezebben mérhető — ügyfélkapcsolat, jogi mérlegelés, kreatív döntés —, ott ugyanez az arány jóval alacsonyabb marad.
Kapcsolódó elemzésünk: AI hallucináció megelőzése: 6 módszer ágenteknél és kódolásnál
Összefoglaló
Az Anthropic adatai szerint fél év alatt 1 százalékról 26 százalékra nőtt az AI-vezérelt kutatás aránya, miközben 30 000 ágens dolgozik párhuzamosan a belső platformon, és a teljes autonómia továbbra is tiltott. A hír igazi tartalma nem a gyorsulás, hanem a mérés: először látunk nyilvános, szintekre bontott képet arról, hogyan oszlik meg a munka ember és modell között egy vezető laborban.
A következő hónapok kérdése az, hogy a többi labor követi-e ezt az átláthatóságot, és hogy a vállalati gyakorlatban mennyire lesz sztenderd az automatizálási szintek mérése. Ha nem akarsz lemaradni ezekről az adatokról, iratkozz fel az AI Hírek hírlevelére — a heti összefoglalóban minden fontos mérési és modellfrissítést megkapsz egy helyen.